
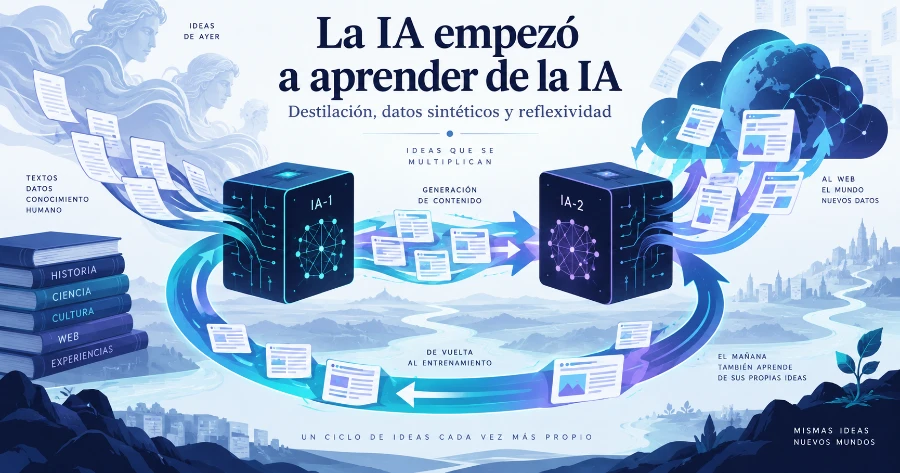
La disputa por la destilación de Claude parece otra pelea tecnológica entre Estados Unidos y China. Pero detrás aparece una pregunta más interesante: ¿qué ocurre cuando las inteligencias artificiales empiezan a modificar el mismo mundo de información del que aprenderán las siguientes?
Claude responde una pregunta. Al otro lado no necesariamente hay una persona intentando resolver una duda. Puede haber otra inteligencia artificial tomando nota.
La escena tiene algo extraño porque se parece menos a una conversación que a esas situaciones en las que alguien entra a una clase, se sienta en la última fila y copia con suficiente disciplina como para reconstruir después buena parte de lo que enseñó el profesor. La diferencia es que aquí el alumno puede hacer millones de preguntas, no se cansa, no necesita dormir y puede repetir la operación hasta descubrir no solo qué responde el profesor, sino también cómo suele llegar a sus respuestas.
A cierta escala, incluso cuesta seguir llamándolo alumno. Es más parecido a una multitud silenciosa que entra por una puerta, pregunta durante semanas y sale por otra llevando pequeños pedazos de una inteligencia ajena. Nadie ve los pedazos. No pesan. No activan ninguna alarma en el aeropuerto. Pero al otro lado pueden terminar convertidos en otra máquina.
Eso es, simplificando bastante, lo que está detrás de una de las disputas más interesantes que se están dando ahora mismo en la industria de la inteligencia artificial.
La primera pista no está en una declaración política. Está en el mecanismo: una IA puede interrogar a otra, conservar las respuestas y convertirlas en materia prima. Si seguimos ese rastro, la historia termina bastante lejos de la disputa inicial.
Anthropic aseguró el 10 de septiembre haber detectado operaciones de varias compañías chinas destinadas a extraer capacidades de Claude. El caso más grande que atribuye a Alibaba habría producido más de 151 millones de interacciones fraudulentas, presuntamente destinadas a mejorar los modelos Qwen de Alibaba. Reuters reportó las acusaciones dejando claro que se trata de afirmaciones de Anthropic, no de hechos establecidos judicialmente.
China rechaza la manera en que Estados Unidos está describiendo el fenómeno. Su Ministerio de Comercio sostiene que la destilación es una técnica habitual en inteligencia artificial y acusa a Washington de convertir una cuestión técnica y comercial en un instrumento para limitar a sus competidores.
Y aquí la discusión comienza a ponerse interesante, porque ambas cosas pueden contener parte de la verdad.
Pista 1: el alumno que aprende del profesor
La destilación no apareció con DeepSeek ni es una invención clandestina de algún laboratorio chino.
La idea básica consiste en utilizar las respuestas de un modelo potente para ayudar a entrenar otro modelo. Un sistema grande puede actuar como una especie de profesor que produce ejemplos, evaluaciones o respuestas que luego aprovecha un sistema más pequeño.
El conflicto aparece cuando un competidor obtiene masivamente las respuestas de un modelo ajeno, mediante accesos que el propietario considera fraudulentos, para intentar transferir sus capacidades.
En ese punto la analogía del profesor empieza a fallar.
Copiar los apuntes de una clase no convierte automáticamente al alumno en profesor. Puede memorizar respuestas y seguir sin comprender otras cosas. En inteligencia artificial ocurre algo parecido: obtener millones de salidas de Claude no significa copiar sus pesos, conocer sus datos originales ni reconstruir exactamente la forma en que fue entrenado.
Pero tampoco son simplemente apuntes.
Las respuestas contienen una manifestación de las capacidades que enormes cantidades de cómputo, datos, investigación e ingeniería ayudaron a producir. Si otro modelo puede absorber parte de ellas por una fracción del costo, aparece una pregunta económica y jurídica bastante difícil:
¿En qué punto aprender de otro modelo deja de ser aprendizaje y comienza a convertirse en extracción de tecnología?
No existe una respuesta tan sencilla como podría sugerir la pelea política.
Pista 2: el rastro sale del laboratorio
Supongamos ahora que Qwen aprende parcialmente de respuestas producidas por Claude.
Después alguien utiliza Qwen para escribir un documento técnico.
Otro utiliza DeepSeek para programar una librería.
Una empresa genera con GPT millones de descripciones de productos.
Un estudiante revisa un trabajo con Gemini.
Un periodista utiliza una IA para reorganizar sus notas y finalmente publica el artículo.
Todo eso termina mezclándose lentamente con internet.
No ocurre de golpe. Nadie enciende una palanca y convierte la red en contenido sintético. Es más parecido a echar tinta en un río. Al principio todavía se distingue el agua. Unos kilómetros después ya resulta difícil decir qué parte vino de la montaña y qué parte salió del frasco.
Aquí vale la pena desviarse un momento.
Una biblioteca tradicional permite imaginar cierta genealogía. Un libro cita otro libro; aquel cita un artículo; el artículo remite a un investigador. Siguiendo el camino con suficiente paciencia todavía es posible llegar hasta una persona sentada alguna vez delante de una mesa, un laboratorio o un archivo.
Internet nunca fue tan ordenado, pero conservaba algo de esa lógica.
Ahora imaginemos una biblioteca donde algunos libros fueron escritos después de leer otros libros que, a su vez, fueron resumidos por máquinas entrenadas parcialmente con versiones anteriores de la misma biblioteca. Los libros siguen en los estantes. Conservan autores, títulos y fechas. Solo que por las noches algunas frases parecen haber cambiado de familia sin que nadie sepa exactamente cuándo ocurrió.
La genealogía intelectual empieza a formar círculos.
No hace falta imaginarlo como una catástrofe. Basta con reconocer que el circuito cambió.
Volvamos a Claude.
Si parte de las respuestas de Claude sirve para mejorar Qwen, y después contenido producido con Qwen termina incorporado a internet, una futura generación de modelos que utilice contenido web podría encontrarse aprendiendo indirectamente de Claude a través de Qwen.
Y Claude podría terminar aprendiendo algún día de información que tiene, entre sus antepasados, al propio Claude.
Es una genealogía rara: una máquina que encuentra entre sus abuelos una versión anterior de sí misma.
Ahí aparece la reflexividad.
Pista 3: el circuito empieza a cerrarse
George Soros utilizó el concepto de reflexividad para explicar un fenómeno de los mercados financieros.
Los participantes intentan comprender una realidad económica para tomar decisiones. Pero esas decisiones modifican la propia realidad que intentaban comprender.
Si suficientes inversionistas creen que una empresa tiene un futuro extraordinario, compran sus acciones. El precio aumenta. Ese precio más alto puede facilitar que la empresa consiga capital, contrate mejores personas o compre competidores. La percepción inicial termina alterando algunos de los fundamentos sobre los cuales posteriormente será evaluada.
La realidad modifica las creencias y las creencias modifican la realidad.
Con la inteligencia artificial está apareciendo un circuito parecido, aunque no idéntico.
Un modelo aprende del entorno informativo.
Después produce información.
Esa información modifica el entorno.
El siguiente modelo aprende del entorno modificado.
Y vuelve a producir información.
IA → información → IA → información.
Parece una flecha sencilla. Pero cuando se repite suficientes veces deja de parecer una flecha y empieza a parecer uno de esos caminos de pueblo que después de varias horas devuelven al viajero al mismo árbol por el que juraba no haber pasado nunca.
El objeto estudiado ya no permanece quieto mientras se construye el instrumento que intenta entenderlo.
Una pista falsa: confundir todo esto con «model collapse»
Hay una tentación fácil en este punto: concluir que si las máquinas empiezan a aprender de otras máquinas, inevitablemente terminarán degenerándose hasta producir basura.
Existe un problema real relacionado con eso, pero hay que manejarlo con cuidado.
En 2024, investigadores publicaron en Nature un trabajo que estudió qué sucede cuando sucesivas generaciones de modelos se entrenan indiscriminadamente con información generada por modelos anteriores. Encontraron un fenómeno denominado model collapse: partes menos frecuentes de la distribución original comienzan a desaparecer y el modelo puede alejarse progresivamente de los datos reales que intentaba representar.
Una forma intuitiva de pensarlo sería hacer una fotocopia de una fotocopia y luego otra de aquella. Las líneas principales sobreviven durante bastante tiempo. Los pequeños detalles desaparecen primero.
Hasta que un día la abuela de la fotografía sigue allí, pero ha perdido primero una arruga, luego un lunar y finalmente esa expresión que permitía reconocer que era ella y no cualquier otra mujer.
Eso es precisamente lo preocupante: no siempre desaparece primero lo más evidente. Pueden desaparecer las rarezas, los casos poco frecuentes, los extremos, las pequeñas irregularidades que también forman parte de la realidad.
Pero sería un error concluir que todo dato sintético es malo.
Los datos generados por IA pueden utilizarse de manera deliberada para entrenar capacidades específicas, crear ejemplos escasos, generar problemas con soluciones verificables o mejorar modelos pequeños. Investigaciones posteriores incluso estudian cómo utilizar datos sintéticos evitando o reduciendo precisamente esos procesos de degradación.
La destilación que denuncia Anthropic y el model collapse tampoco son la misma cosa.
Una operación de destilación puede seleccionar cuidadosamente respuestas de alta calidad de un modelo superior. El model collapse estudiado por los investigadores aparece en ciclos de entrenamiento recursivo donde la información sintética va reemplazando o deformando la distribución original.
El vínculo entre ambos fenómenos es otro.
Ambos muestran que la producción de una IA puede convertirse en materia prima para otra IA.
Y esa materia prima está creciendo.
Pista 4: cuanto más sintético el mundo, más valiosa la procedencia
Aquí ocurre algo contraintuitivo.
Si generar texto, código, imágenes y datos sintéticos se vuelve prácticamente gratuito, podría parecer que los datos dejarán de tener valor.
Puede ocurrir exactamente lo contrario con ciertos datos.
Una conversación auténtica entre personas.
Una medición tomada por un sensor.
Un experimento de laboratorio.
Una historia clínica correctamente anonimizada.
Una encuesta.
Un registro empresarial.
Una fotografía cuya procedencia pueda demostrarse.
Un documento escrito antes de la explosión de los modelos generativos.
Todo aquello que pueda probar que proviene directamente del mundo empieza a adquirir una característica nueva: no forma parte del circuito sintético.
Quizá terminemos haciendo con la información algo parecido a lo que hacemos con ciertos objetos antiguos. No porque sean necesariamente mejores, sino porque podemos demostrar que estaban allí antes de que llegara la máquina.
Un periódico impreso en 1998 podría no contener mejores ideas que uno escrito en 2030. Pero nadie tendrá que preguntarse si sus párrafos fueron redactados por un modelo que aprendió de otro modelo que había resumido una página escrita por un tercero.
La procedencia empieza a convertirse en una cualidad.
Los autores del trabajo de Nature llegan precisamente a una conclusión relacionada: a medida que aumenta el contenido generado por modelos disponible en internet, los datos procedentes de interacciones humanas genuinas pueden hacerse más valiosos para entrenar futuras generaciones.
Es una pequeña paradoja.
Cuanto más barato resulte fabricar información, más costosa puede hacerse la información cuya procedencia podemos demostrar.
Pista 5: seguir una idea hasta su origen se vuelve difícil
Hay otra consecuencia todavía más incómoda.
Supongamos que un modelo descubre una forma particularmente elegante de resolver cierto problema matemático.
La solución aparece en miles de respuestas.
Algunas son utilizadas para entrenar otros modelos.
Estos encuentran variaciones.
Las variaciones aparecen en documentos.
Los documentos alimentan nuevos sistemas.
Tres generaciones después, un modelo produce una idea parecida pero considerablemente mejor.
¿De quién es?
La pregunta parecía filosófica hasta que los modelos empezaron a participar en investigación científica real.
Esta misma semana OpenAI publicó una solución generada por uno de sus sistemas para el problema de existencia y suavidad de Navier–Stokes, uno de los Problemas del Milenio. La publicación incluye una prueba formalizada en Lean y una sección dedicada al trabajo concurrente y a la responsabilidad científica.
No hace falta resolver aquí la controversia sobre autoría científica para advertir el cambio.
Nuestro sistema de atribución intelectual está construido alrededor de una genealogía relativamente sencilla:
alguien aprendió algo → pensó algo → produjo algo.
La IA introduce ramas nuevas:
alguien produjo algo → un modelo aprendió de ello → otro modelo aprendió del primero → alguien utilizó ese segundo modelo → apareció algo nuevo.
Encontrar al antepasado de una idea puede terminar siendo considerablemente más difícil que encontrar al autor de un documento.
Tal vez una idea del futuro llegue a una oficina sin saber quién fue su padre. Tendrá documentos, fechas, versiones y cientos de rastros digitales. Solo le faltará aquello que antes parecía lo más sencillo: una historia familiar.
La última conexión: China era solo la puerta de entrada
Por eso reducir el episodio de Anthropic a “China está copiando la IA estadounidense” desperdicia la parte realmente interesante.
Existe una disputa comercial.
Existe una disputa geopolítica.
Existe una discusión legítima sobre propiedad intelectual, términos de servicio y acceso a modelos.
También existe una carrera en la que Estados Unidos intenta conservar una ventaja tecnológica mientras China intenta reducirla, y en la que la eficiencia de los modelos se ha convertido en una variable tan importante como la cantidad bruta de cómputo.
Pero debajo de todo eso está ocurriendo otra cosa.
Los modelos ya no son solamente consumidores del conocimiento acumulado por la humanidad.
Se están convirtiendo también en productores del entorno epistemológico en el que serán entrenados sus sucesores.
En algún lugar de un centro de datos, una respuesta producida hoy puede dormir unos meses, reaparecer transformada dentro de otro modelo y regresar años después como si fuera una idea nueva. Nadie escuchará el viaje. Los servidores no guardan fantasmas, al menos no en el sentido tradicional. Pero empiezan a guardar genealogías.
Eso cambia la pregunta.
Hasta ahora nos preocupaba qué aprendería la inteligencia artificial de nosotros.
La siguiente pregunta puede ser bastante más extraña: ¿qué aprenderá la inteligencia artificial de un mundo que ya ha sido parcialmente escrito por ella misma?
Referencias
- Reuters — “Anthropic disrupts Russian, Chinese AI campaigns targeting its Claude models”, 10 de septiembre de 2026.
- Associated Press — respuesta de China a las acusaciones estadounidenses sobre destilación, 9 de septiembre de 2026.
- Shumailov et al. — AI models collapse when trained on recursively generated data, Nature, 2024.
- Zhu et al. — How to Synthesize Text Data without Model Collapse?, ICML 2025.
- George Soros — trabajos sobre falibilidad y reflexividad.
- OpenAI — On the Navier–Stokes Millennium Prize Problem, 8 de septiembre de 2026.
